前言
在复杂多变的环境中,人类能够通过“吃一堑长一智”来实时调整自己的行为策略。为了让 LLM 具备持续学习的能力,传统的做法是引入强化学习(RL,如 PPO)进行微调。但这带来了两个致命问题:高昂的计算成本与难性遗忘(Catastrophic Forgetting)。
这篇被 ICML 2026 接收为 Spotlight 的顶会论文《Just-In-Time Reinforcement Learning: Continual Learning in LLM Agents Without Gradient Updates》,提出了一种极其优雅的破局方案:JitRL。它在完全不更新模型梯度的情况下,通过测试时(Test-time) 的 Logits 调制实现了策略优化。相较于昂贵的 RL 微调方案,它不仅拿下了 SOTA,更将成本降低了惊人的 30 倍!
🔗 论文地址:arXiv:2601.18510
💻 开源代码:GitHub - liushiliushi/JitRL
1. 什么是 JITRL?
JitRL (Just-In-Time RL) 是一种面向 LLM Agent 的即时强化学习框架。传统 RL 在离线或在线训练阶段通过反向传播更新网络参数,而 JitRL 则完全抛弃了参数更新,将 RL 的核心逻辑后置到了推理阶段(Test-time)。
JitRL 的核心哲学是:利用非参数化记忆 (Non-parametric Memory)检索过去的经验,实时估计当前动作的“优势(Advantage)”,并直接干预 LLM 的输出分布 Logits。
这使得LLM Agent拥有在部署后 持续适应新环境、学习新任务的可能性,并有效降低灾难性遗忘的风险。
2. 核心机制深度解析:如何实现免梯度的 RL?
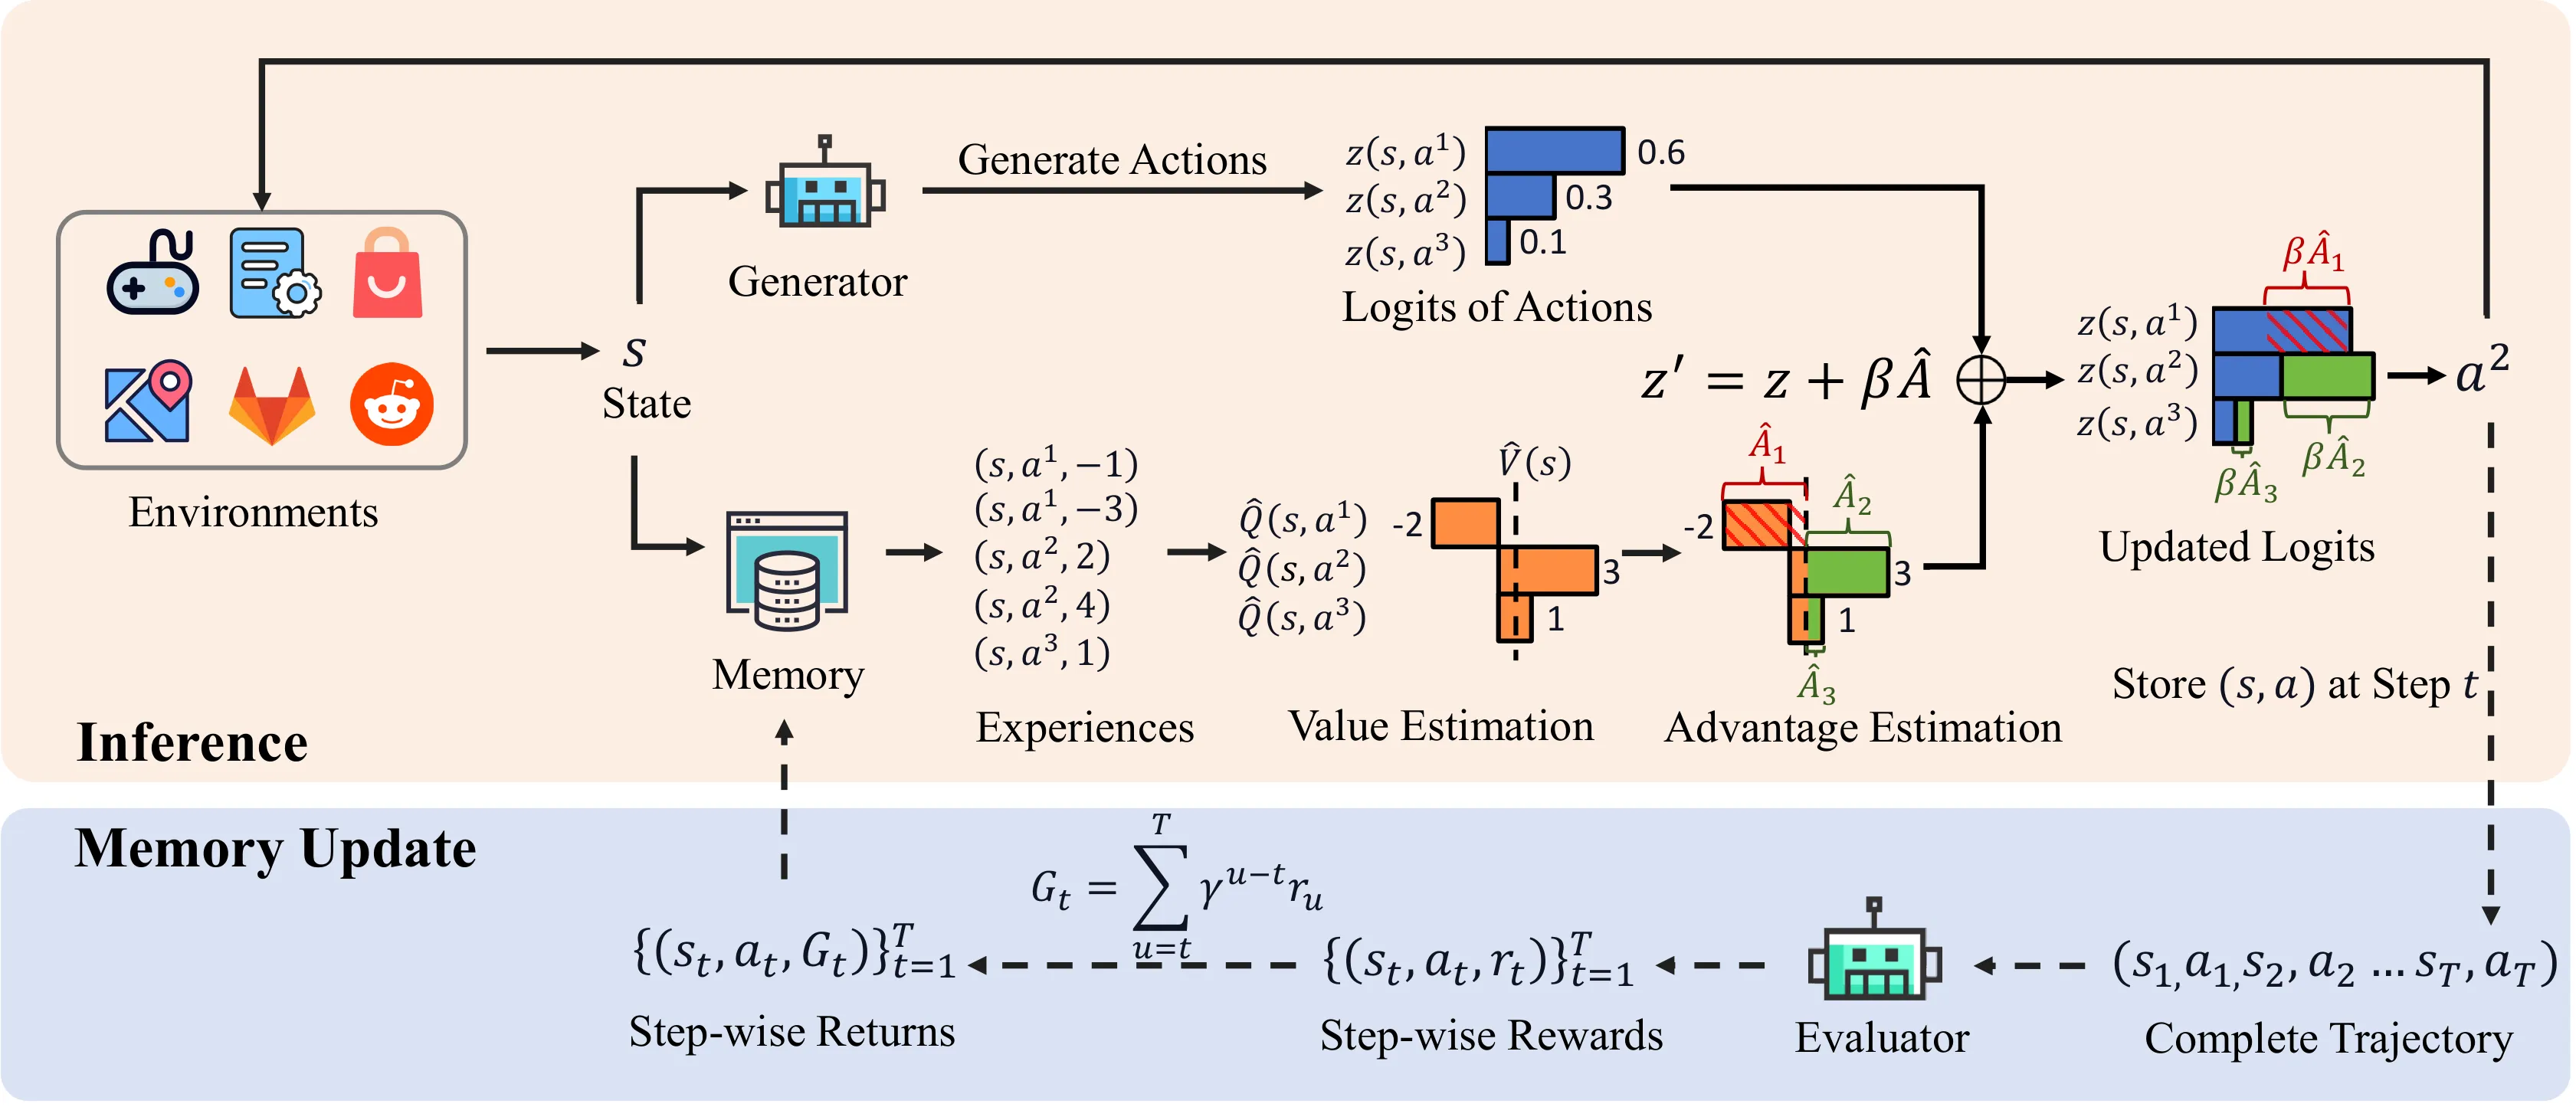
JitRL 的架构主要包含两个数据流:
- 推理干预流 (Inference Stream) 与 记忆更新流 (Memory Update Stream)
2.1 动态非参数化记忆 (Dynamic Non-parametric Memory)
代替在神经网络权重中隐式存储知识,JitRL 维护了一个显式的外部记忆库(Memory)。
当Agent智能体完成一次完整的任务轨迹后,评估器(Evaluator)会对轨迹的每一步进行带有时间衰减的累计回报的打分(Return, ),然后存入记忆库 的数据格式为 。
Agent智能体在环境中交互的每一步,都会被记录为 <状态 (State), 动作 (Action), 奖励 (Reward)> 的轨迹三元组。随着交互的进行,这个记忆库 会不断动态扩充,成为智能体的“经验宝库”(Experiences)。
2.2 即时优势估计 (On-the-fly Advantage Estimation)
当智能体面临新的决策状态时,先进行“回忆”:
- 轨迹检索:基于 Jaccard + N-gram相似度匹配(零训练零参数框架的必然选择),从记忆库 中,通过带权重的回归 KNN(K近邻)检索出与当前上下文最相似的K个历史轨迹。
- 计算优势 : (其中 是过去经验在状态s-动作a的平均动作价值, 是过去经验在状态s的平均基线价值)。
2.3 测试时 Logits 调制 (Test-time Logit Modulation)
计算出 Advantage 之后怎么办?传统做法是用它来算 Loss 并反向传播更新权重。而 JitRL 选择直接在推理期修改 LLM 的输出概率分布(logits)。
论文从理论上给出了严谨的数学证明,得出:直接对 LLM 的输出 Logits 进行加法更新,正是 KL 散度约束下,策略优化目标的精确闭式解 (Exact Closed-form Solution)。
推导直觉如下: 在标准的带 KL 惩罚项的 RL 目标中(类似于 PPO/DPO 的底层逻辑),最优策略 满足:
两边同时取对数(Log),忽略归一化常数项,可得:
而对应到LLM的底层,由 Softmax: ,得 就是 LLM 原始输出的 Logit!因此,更新公式即为简单的一维加法:
这意味着,只需要将实时算出的 Advantage 缩放后加上 LLM 原始的 Logits 上,就等于完成了以此 Advantage 为目标的严格 RL 梯度更新!
2.4 笔者实力不足,还无法完全理解的部分(手动狗头)
论文并未额外训练复杂的奖励模型(Reward Model),而是极其神秘地采用了“特定的 Prompt + 冻结权重的基座 LLM”来构建 Evaluator。 在一个完整的任务回合结束后,系统会利用 Prompt 引导 LLM 充当“事后裁判”,逐帧审视历史轨迹。LLM 会基于常识推理,评估每一步动作引发的结果及其对推进最终目标的实际贡献,从而给出具体的步级奖励 。
3. 总结与启发
在 “System 2 Thinking” 和 “Test-time Scaling” 越来越火的 2026 年,JitRL 提供了一个极为新颖的视角:强化学习并不一定要发生在训练阶段。
通过将强化学习的目标函数重构为推理时的 Logits 数学调制,JitRL 不仅做到了精确的策略优化,还优雅地规避了 RLHF/RLAIF 长期存在的训练门槛高、超参难调、易灾难性遗忘等工程噩梦。
对于正在构建下一代自主智能体(Autonomous Agents)的开发者来说,JitRL 证明了:给大模型外挂一个能够精准计算并实时注入 Advantage 的“经验大脑”,或许比花费巨资微调模型权重,是一条更具性价比、也更符合人类学习直觉的康庄大道。